Trackingfehler stoppen: AI-gestütztes Testing für zuverlässige Analytics-Daten
Management Summary
Jede*r Analyst*in oder Data Engineer kennt dieses flaue Gefühl in der Magengegend. Ein Blick auf das Dashboard am Montagmorgen zeigt: Die E-Commerce-Conversion-Rate ist übers Wochenende plötzlich um 80 % eingebrochen.
Was war passiert? Ein*e Frontend-Entwickler*in hat am Freitagnachmittag einen kleinen Hotfix am Checkout ausgerollt. Dabei veränderte er unabsichtlich die Struktur des Data Layers.
Im besten Fall fällt der Fehler am Montag auf. Oft bleiben solche „Silent Failures“ jedoch wochenlang unentdeckt. Die Website funktioniert perfekt, aber das Tracking bricht im Hintergrund ab. Das verfälscht Reportings, torpediert Algorithmen im Performance Marketing und verbrennt bares Geld.
Die traditionelle Lösung? Analyst*innen klicken sich nach jedem Release manuell durch den Google Tag Manager (GTM) Preview Modus. Bei agilen Entwicklungszyklen mit mehreren Deployments am Tag skaliert das jedoch nicht mehr.
Das Fundament: Deterministisches Testing
Bevor wir über Künstliche Intelligenz sprechen, müssen wir die Basis schaffen. Modernes Tracking Testing basiert auf Headless-Browsern. Frameworks wie Playwright oder Cypress steuern diese Browser fern. Sie simulieren User Journeys vollautomatisiert. Sie klicken auf Buttons, füllen Formulare aus und navigieren durch den Shop.
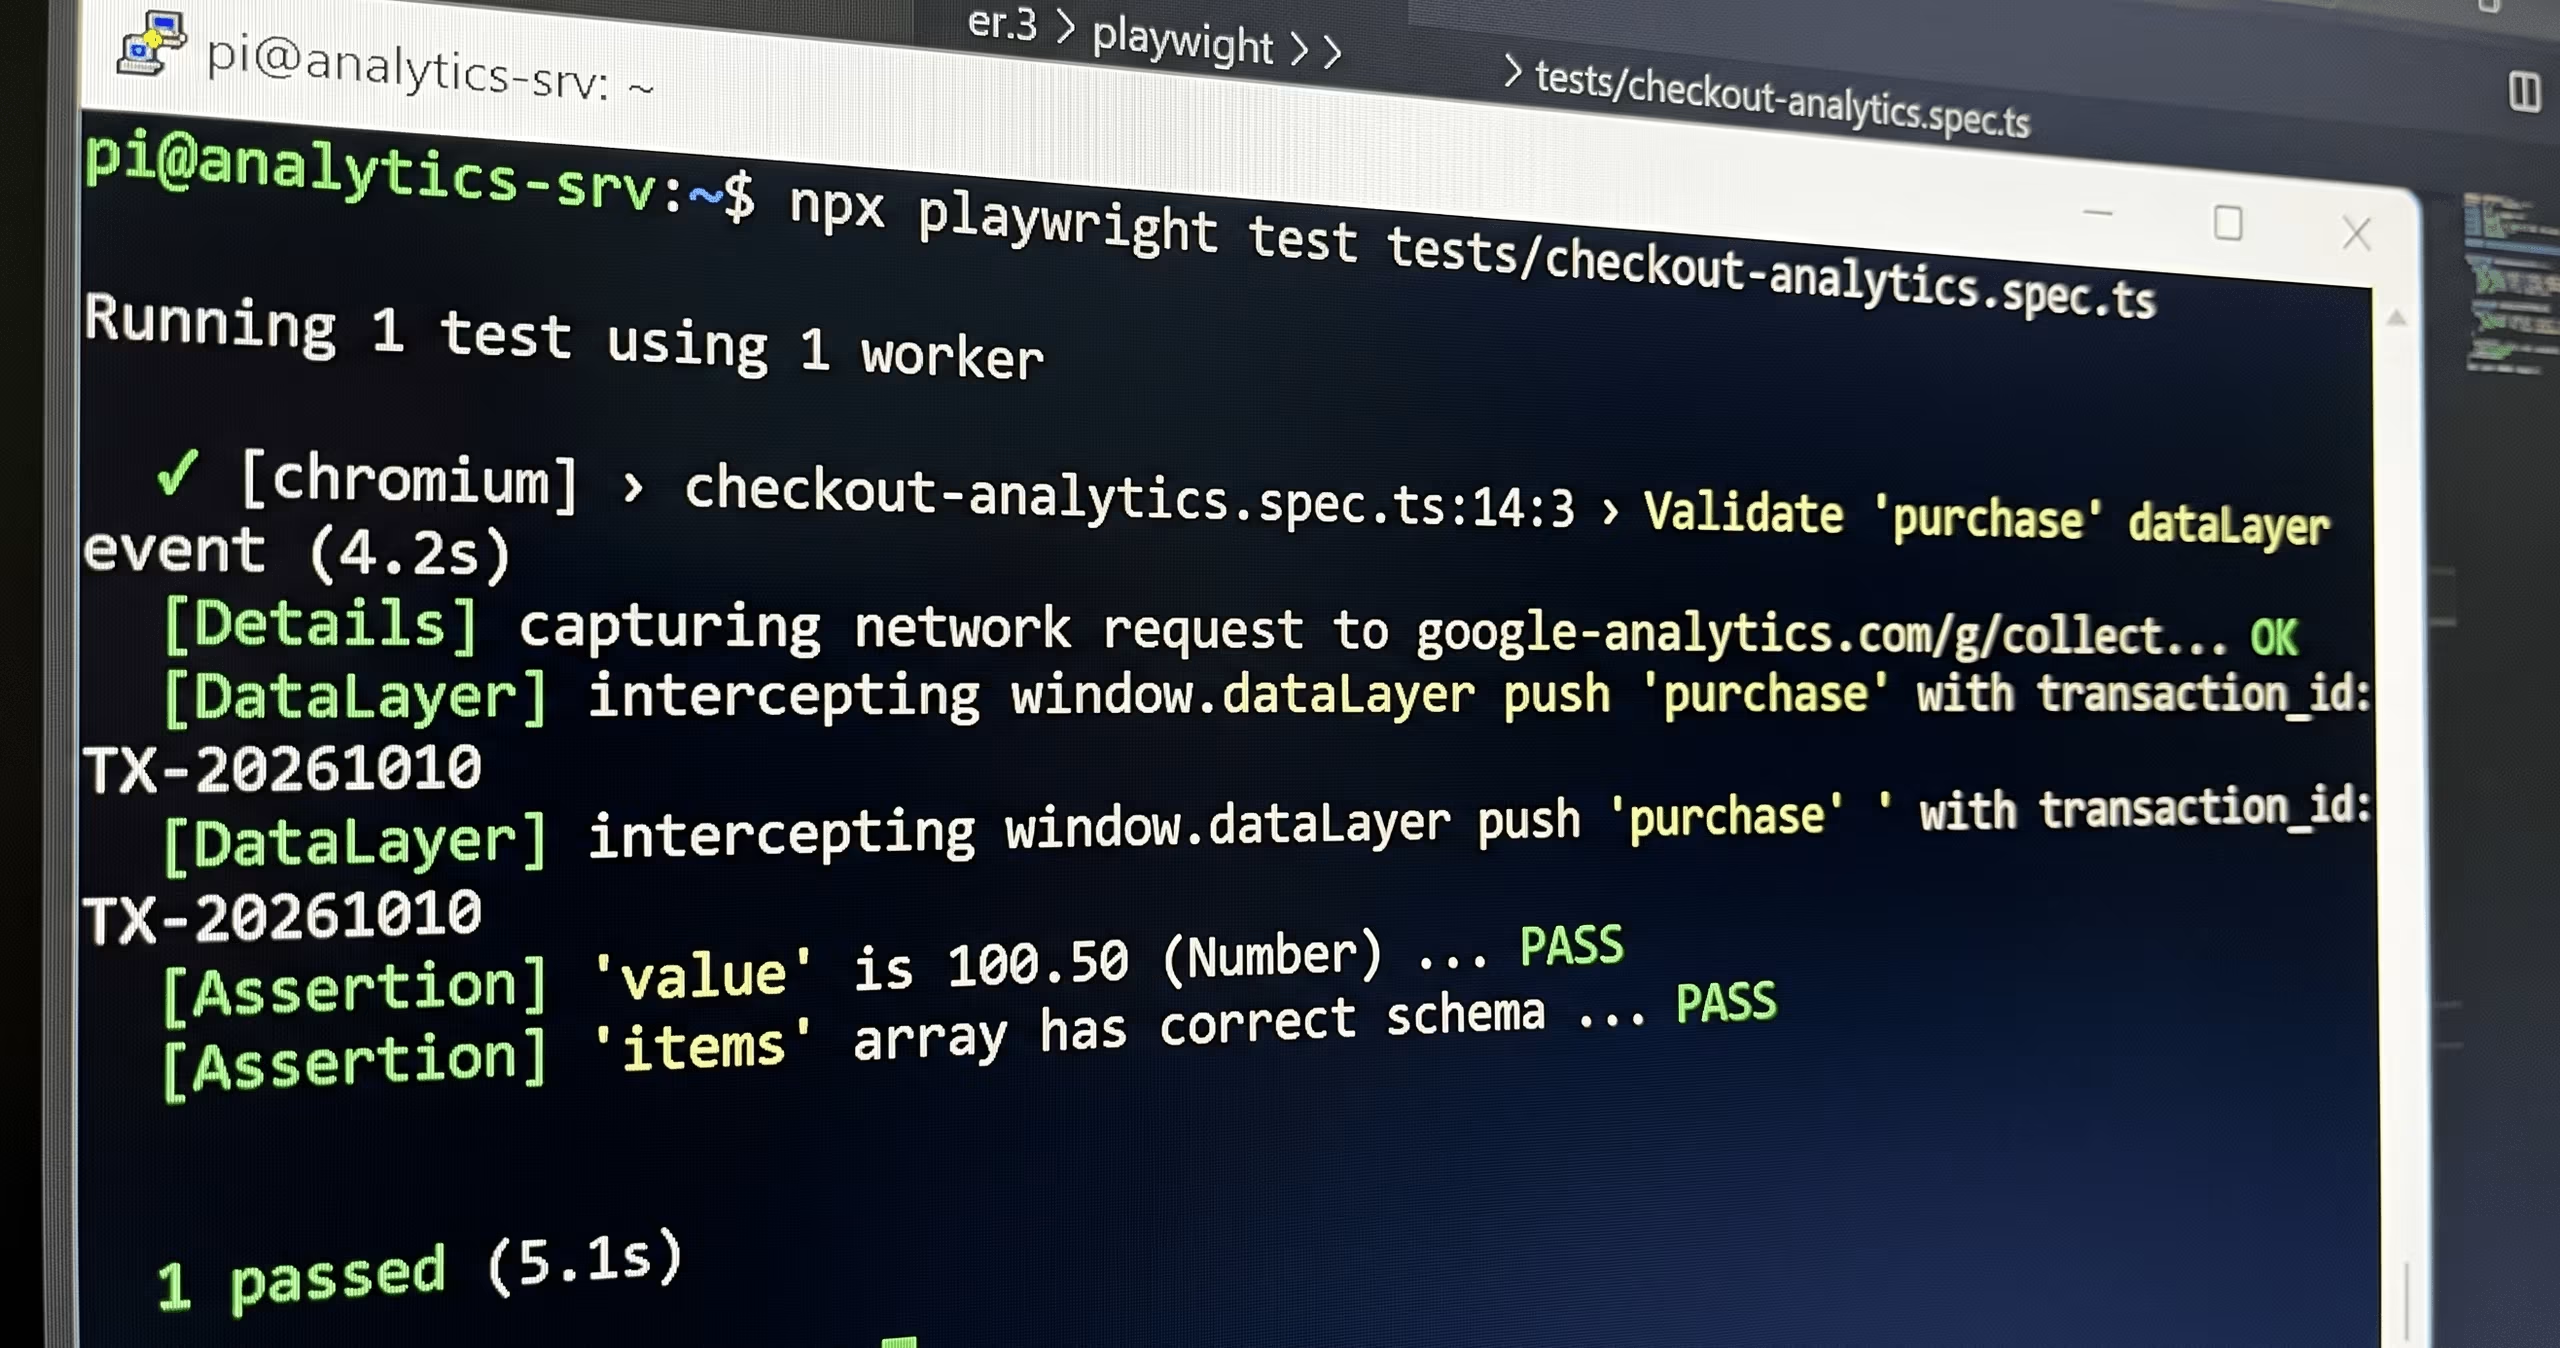
Bild: Tracking-Testing
Für uns im Analytics Bereich sind dabei drei technische Konzepte entscheidend:
dataLayer-Interception
Das Testscript wartet nicht nur auf die „Dankeseite”. Es liest den JavaScript-Kontext der Seite aus, konkret das Array window.dataLayer. So validieren Teams exakt, welche Variablen zum Zeitpunkt des Events bereitstanden – unabhängig davon, wie der Tag Manager sie anschließend verarbeitet.
Network-Request-Mocking
Niemand will produktive GA4-Daten mit Testtraffic verschmutzen. Automatisierte Tests fangen ausgehende Tracking-HTTPS-Requests ab. Das Script prüft die Payload auf Korrektheit und blockiert den Request anschließend. Der Browser löst den Request zwar aus, das Testscript fängt ihn jedoch ab, bevor er das Netzwerk verlässt. In GA4 kommt nichts an.
Consent-Handling
Ohne Zustimmung feuert das Tracking in der Regel nicht. Das Testscript bedient deshalb zuerst den Consent-Banner und prüft idealerweise beide Fälle: Werden nach einer Zustimmung alle Tags ausgelöst, und bleiben nach einer Ablehnung die entsprechenden Requests tatsächlich aus?
Der KI Faktor: Wie künstliche Intelligenz das Testing aufwertet
Klassische End-to-End-Tests haben eine große Schwachstelle. Sie sind extrem fragil. Ändert ein*e Entwickler*in den CSS-Selektor eines „In den Warenkorb“-Buttons, bricht der Test sofort ab. Das Tracking funktioniert eigentlich noch, doch der Test schlägt falschen Alarm.
Hier bringen moderne KI-gestützte Testing Tools den entscheidenden Durchbruch:
Self-Healing-Tests
AI Testing-Plattformen erfassen Webseiten Elemente holistisch. Sie verlassen sich nicht auf eine einzige ID. Ändert sich ein CSS-Selektor, erkennt die KI den Button am visuellen Kontext und am Text. Sie repariert das Testscript („Self-Healing“) automatisch. Das senkt den Wartungsaufwand enorm. Wichtig dabei: Self-Healing kann auch echte Fehler überdecken, etwa wenn sich die Funktion eines Buttons tatsächlich geändert hat. Automatische Reparaturen sollten deshalb protokolliert und regelmäßig von einem Menschen geprüft werden.
Anomaly Detection in der Payload
Traditionelle Scripts nutzen starre „Wenn-Dann“-Regeln. Machine Learning-Modelle hingegen lernen den „Normalzustand“ eines Tracking Payloads. Weist das Array der übergebenen Produkte plötzlich eine untypische Struktur auf, schlägt das System Alarm. Teams finden so Fehler, für die sie nie einen expliziten Test geschrieben haben. Da solche Modelle historische Daten benötigen, spielen sie ihre Stärke vor allem im Monitoring des Live-Betriebs aus. Für Tests vor dem Release eignet sich als deterministischer Zwischenschritt eine Schema Validierung der Payload, etwa per JSON Schema.
Die Praxis: Ein Test-Setup für das wichtigste Event
Wie sieht so eine Validierung in der Praxis aus? Nehmen wir das kritischste aller Events: Den Kauf (purchase).
Ein automatisiertes Script durchläuft den Checkout Prozess. Es fängt den dataLayer Push ab. Nun feuert das System sogenannte Assertions (strikte Prüfungen) ab:
- Existenz: Kam das Event mit dem Namen purchase überhaupt an?
- Transaktionsdaten: Existiert der Parameter transaction_id? Ist er ein String (Text) und nicht „undefined“?
- Datentypen: Übergibt das System den Umsatz (value) strikt als Zahl (Number)? Ein String wie „100,50€“ statt 100.50 erzeugt viele Probleme in Analytics.
- Währung: Wird zusammen mit value auch der Parameter currency (z. B. „EUR“) übergeben? Ohne ihn verarbeitet GA4 den Umsatz nicht korrekt.
-
Array Integrität: Beinhaltet das Items Array exakt die Produkteigenschaften (ID, Name, Preis), die das Script zuvor simuliert in den Warenkorb legte?
Fehlen Parameter, die das Tracking Tool als Pflichtfeld vorgibt?
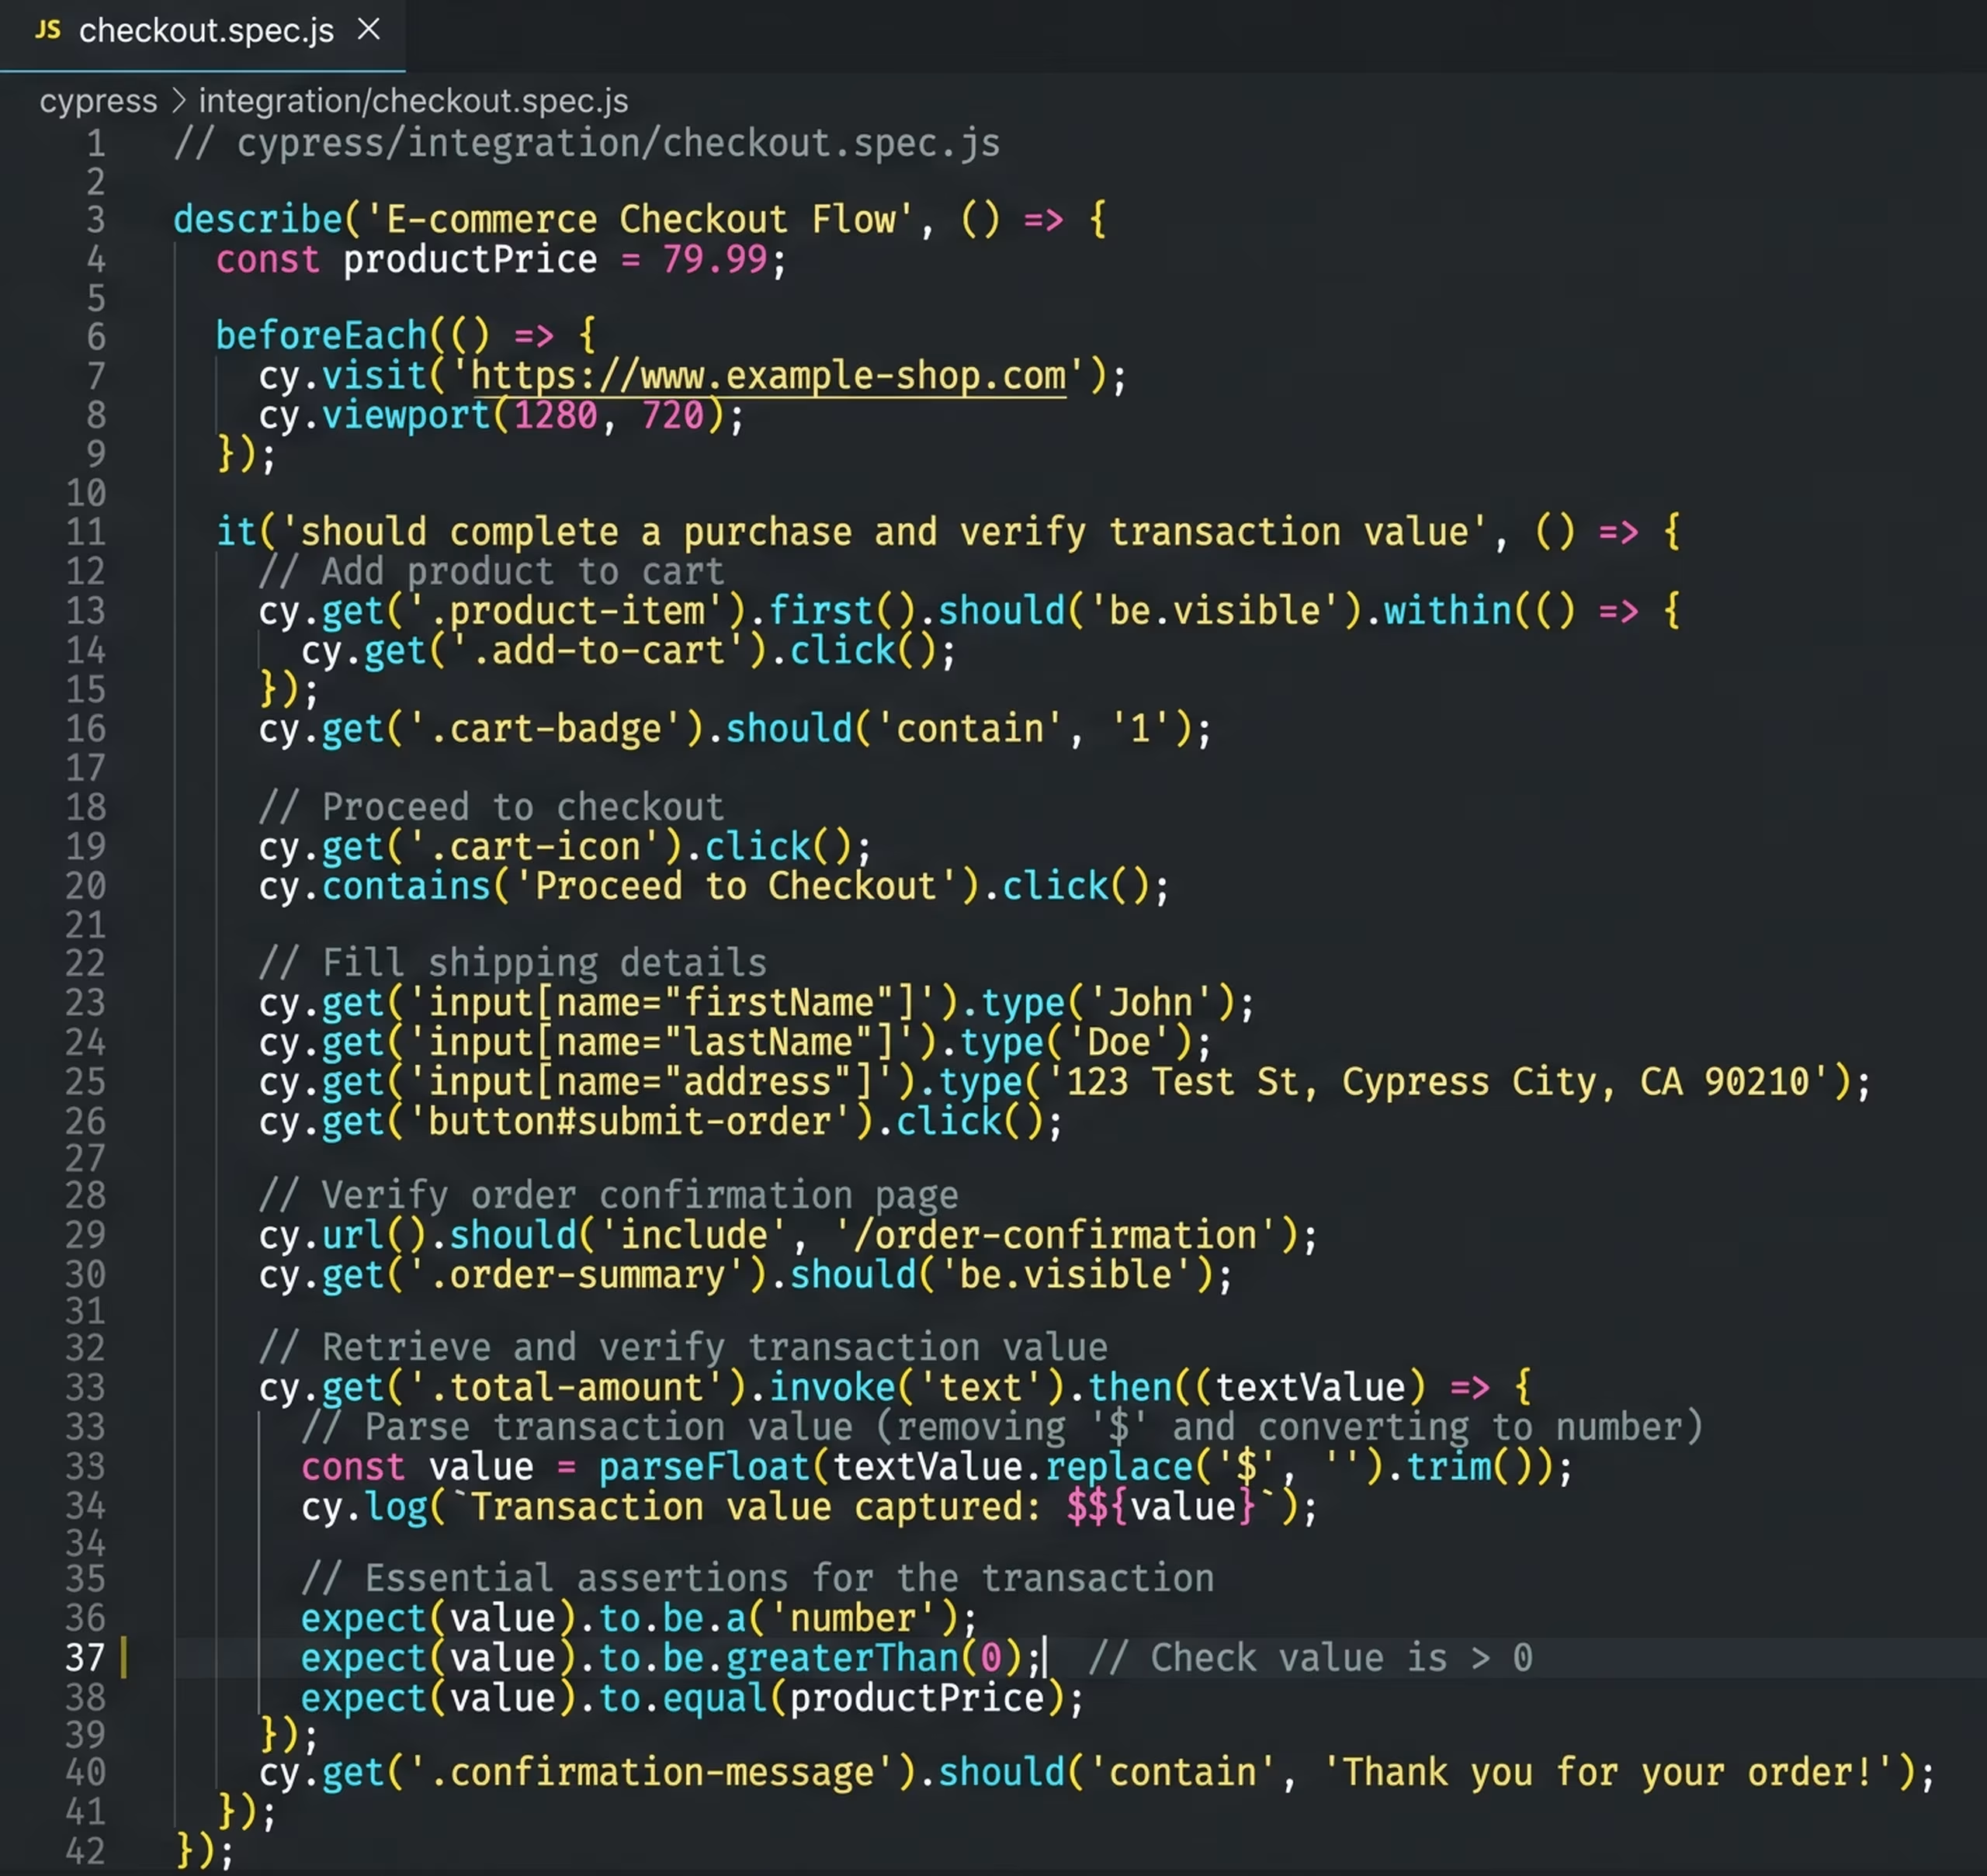
Bild: Beispiel für ein automatisiertes Testscript
Automatische Qualitätsprüfung: Fehler stoppen, bevor die Website live geht
Das beste Testscript nützt rein gar nichts, wenn es ungenutzt auf dem Laptop eines*r Analyst*in herumliegt. Der entscheidende Trick ist, diese Prüfungen fest in den täglichen Arbeitsablauf der Software Entwickler einzubauen.
In der IT-Welt nennt sich dieser Ansatz „Shift-Left“: Fehler werden so früh wie möglich gesucht und behoben – also ganz links am Anfang der Kette, noch während der Code geschrieben wird, und nicht erst, wenn die Website schon live und für alle Besucher*innen sichtbar ist.
Das Prinzip ähnelt einer automatisierten Schranke in einer Fabrik. In der Softwareentwicklung heißt diese Schranke CI/CD-Pipeline. Der Ablauf funktioniert so:
-
01
Die Änderung landet vor der Schranke
Bevor die Änderung für echte Kunden sichtbar wird, bleibt die Schranke geschlossen. Die gesamte Seite mit der Änderung wird zunächst in eine abgeschottete, versteckte Testumgebung (Staging/Laborumgebung) geladen.
-
02
Die automatische Prüfung
Nun startet im Hintergrund völlig automatisch unser Tracking Test. Er tut so, als wäre er ein*e Kunde*in, und prüft, ob alle Daten im Hintergrund noch richtig fließen.
-
03
Fehler gefunden? Baustopp!
Wenn der Test bemerkt, dass das Tracking durch die Änderung kaputtgehen würde, schlägt das System sofort Alarm. Der neue Code wird blockiert und darf nicht live gehen. Das Team bekommt sofort eine Nachricht (z. B. über Slack, Telegram oder E-Mail): „Achtung, der neue Bestell-Button zerstört unsere Messdaten!“ Der/die Programmierer*in muss erst nachbessern.
-
04
Alles super? Go Live!
Erst wenn der Test grünes Licht gibt und beweist, dass alle Daten weiterhin fehlerfrei erfasst werden, öffnet sich die Schranke. Die Änderung geht live.
Die gleiche Mechanik lässt sich natürlich nicht nur aufs Tracking, sondern auf alle Bereiche einer Website oder App anwenden.
Dank dieses unsichtbaren Sicherheitsnetzes können Entwickler*innen in Ruhe an der Website arbeiten, während das Marketing- und Datenteam sicher sein kann: Unsere Messdaten bleiben lückenlos und unbeschädigt.
Wichtig: Änderungen im Google Tag Manager laufen an dieser Schranke vorbei. Wer einen neuen GTM-Container veröffentlicht, löst keinen Code Deployment aus, die Pipeline startet also gar nicht. Als Ergänzung empfehlen sich deshalb regelmäßige automatisierte Tests gegen die Live Website, etwa stündlich oder täglich. So fallen auch Fehler auf, die nicht durch neuen Code, sondern durch Änderungen an der Tag-Konfiguration entstehen.
Fazit
Die Zeiten des Hoffens und Bangens nach jedem Webseite-Release sollten der Vergangenheit angehören. Hohe Datenqualität entsteht nicht durch Zufall. Sie ist das Resultat solider technischer Prozesse. Wer sein Setup mit deterministischem Testing absichert, AI Tools nutzt, Analytics in der Entwicklungspipeline verankert und den Live-Betrieb kontinuierlich überwacht, schützt die Datenintegrität des gesamten Unternehmens.